Originally written for Percona Blog in October, 2026 – Why you should stop using ARBITERS in MongoDB
Este artigo nasceu de uma conversa com um colega de time, sobre o uso da feature de árbitro em instalações de MongoDB hoje.
Depois de olhar alguns casos reais que vimos no suporte, talvez seja hora de dizer adeus aos árbitros.
Não estamos dizendo que a feature está quebrada. Mas sim que a confusão que ela gera, e o custo dessa escolha, raramente combinam com o jeito que as pessoas rodam MongoDB hoje.
Este artigo é a nossa observação sobre por que os Árbitros foram uma feature interessante no passado e não são mais, e por que você deveria repensar o uso em produção.
Há muito tempo.
Nas primeiras versões do MongoDB, em 2010, foi quando o Árbitro foi introduzido como o conhecemos.
O objetivo sempre foi ajudar nas eleições. A recomendação é mirar um número ímpar de membros e, portanto, de votos.
Mas os times queriam um número ímpar de votos sem pagar outro nó de dados. Aí entra o Árbitro: é barato, vota, não guarda dado, não aplica o oplog. É leve.
Esse desenho responde a um problema de voto. Nunca respondeu a um problema de durabilidade de dados, e nunca vai responder.
Isso servia, até o MongoDB passar a tratar durabilidade como parte central do produto.
Majority, majority em todo lugar.
Foi nas eras 3.x e 4.x que a durabilidade evoluiu em várias áreas:
- WiredTiger virou a storage engine padrão.
- O protocolo do replica set passou para
pv1. readConcernewriteConcernfizeram de"majority"uma opção crucial.- Change streams.
- Transações de multi-documento.
- Flow control.
- Read/write concern padrão do cluster.
Tudo isso usa majority do seu próprio jeito.
Um Árbitro ajuda na eleição e na maioria dos votos. O cluster agora também depende de outros tipos de maioria: maioria de escrita, leituras majority-committed, e o que foi construído em cima delas.
Se você é DBA ou especialista em MongoDB, essas distinções podem estar claras para você. Porém, para a maioria dos usuários (sem trocadilho), não estão. Pior: o cluster trava ou bate em problema de performance por causa da topologia que você escolheu.
Os majorities que importam (e o arbiter que não entra nelas).
Vamos esquecer a eleição por um momento e olhar os cenários em que um Árbitro não significa nada. São problemas que a gente continua vendo. E a maior parte teria sido simples de evitar com um nó que guarda dados.
Caso 1 – Um DR que elegeu bem e depois parou de escrever:
Um cluster sharded com três shards, mais um replica set de config servers.
Cada shard tinha três membros com dados num data center (DC1), três no outro (DC2), e um arbiter num terceiro site (DC3).
- Sete membros votantes por shard: seis com dados, um só voto.
Os config servers foram montados de outro jeito.
- Seis membros com dados, dois em cada site (2×3). Sem arbiter.
Um data center caiu. As eleições terminaram, e cada shard tinha um primary novo. Minutos depois, o throughput de escrita caiu de cerca de 3-4k ops/s por shard para uns 50-75 ops/s.
- A aplicação escrevia pelo
mongoscom{ w: 2, j: true }, e três membros com dados ainda estavam de pé em cada shard.
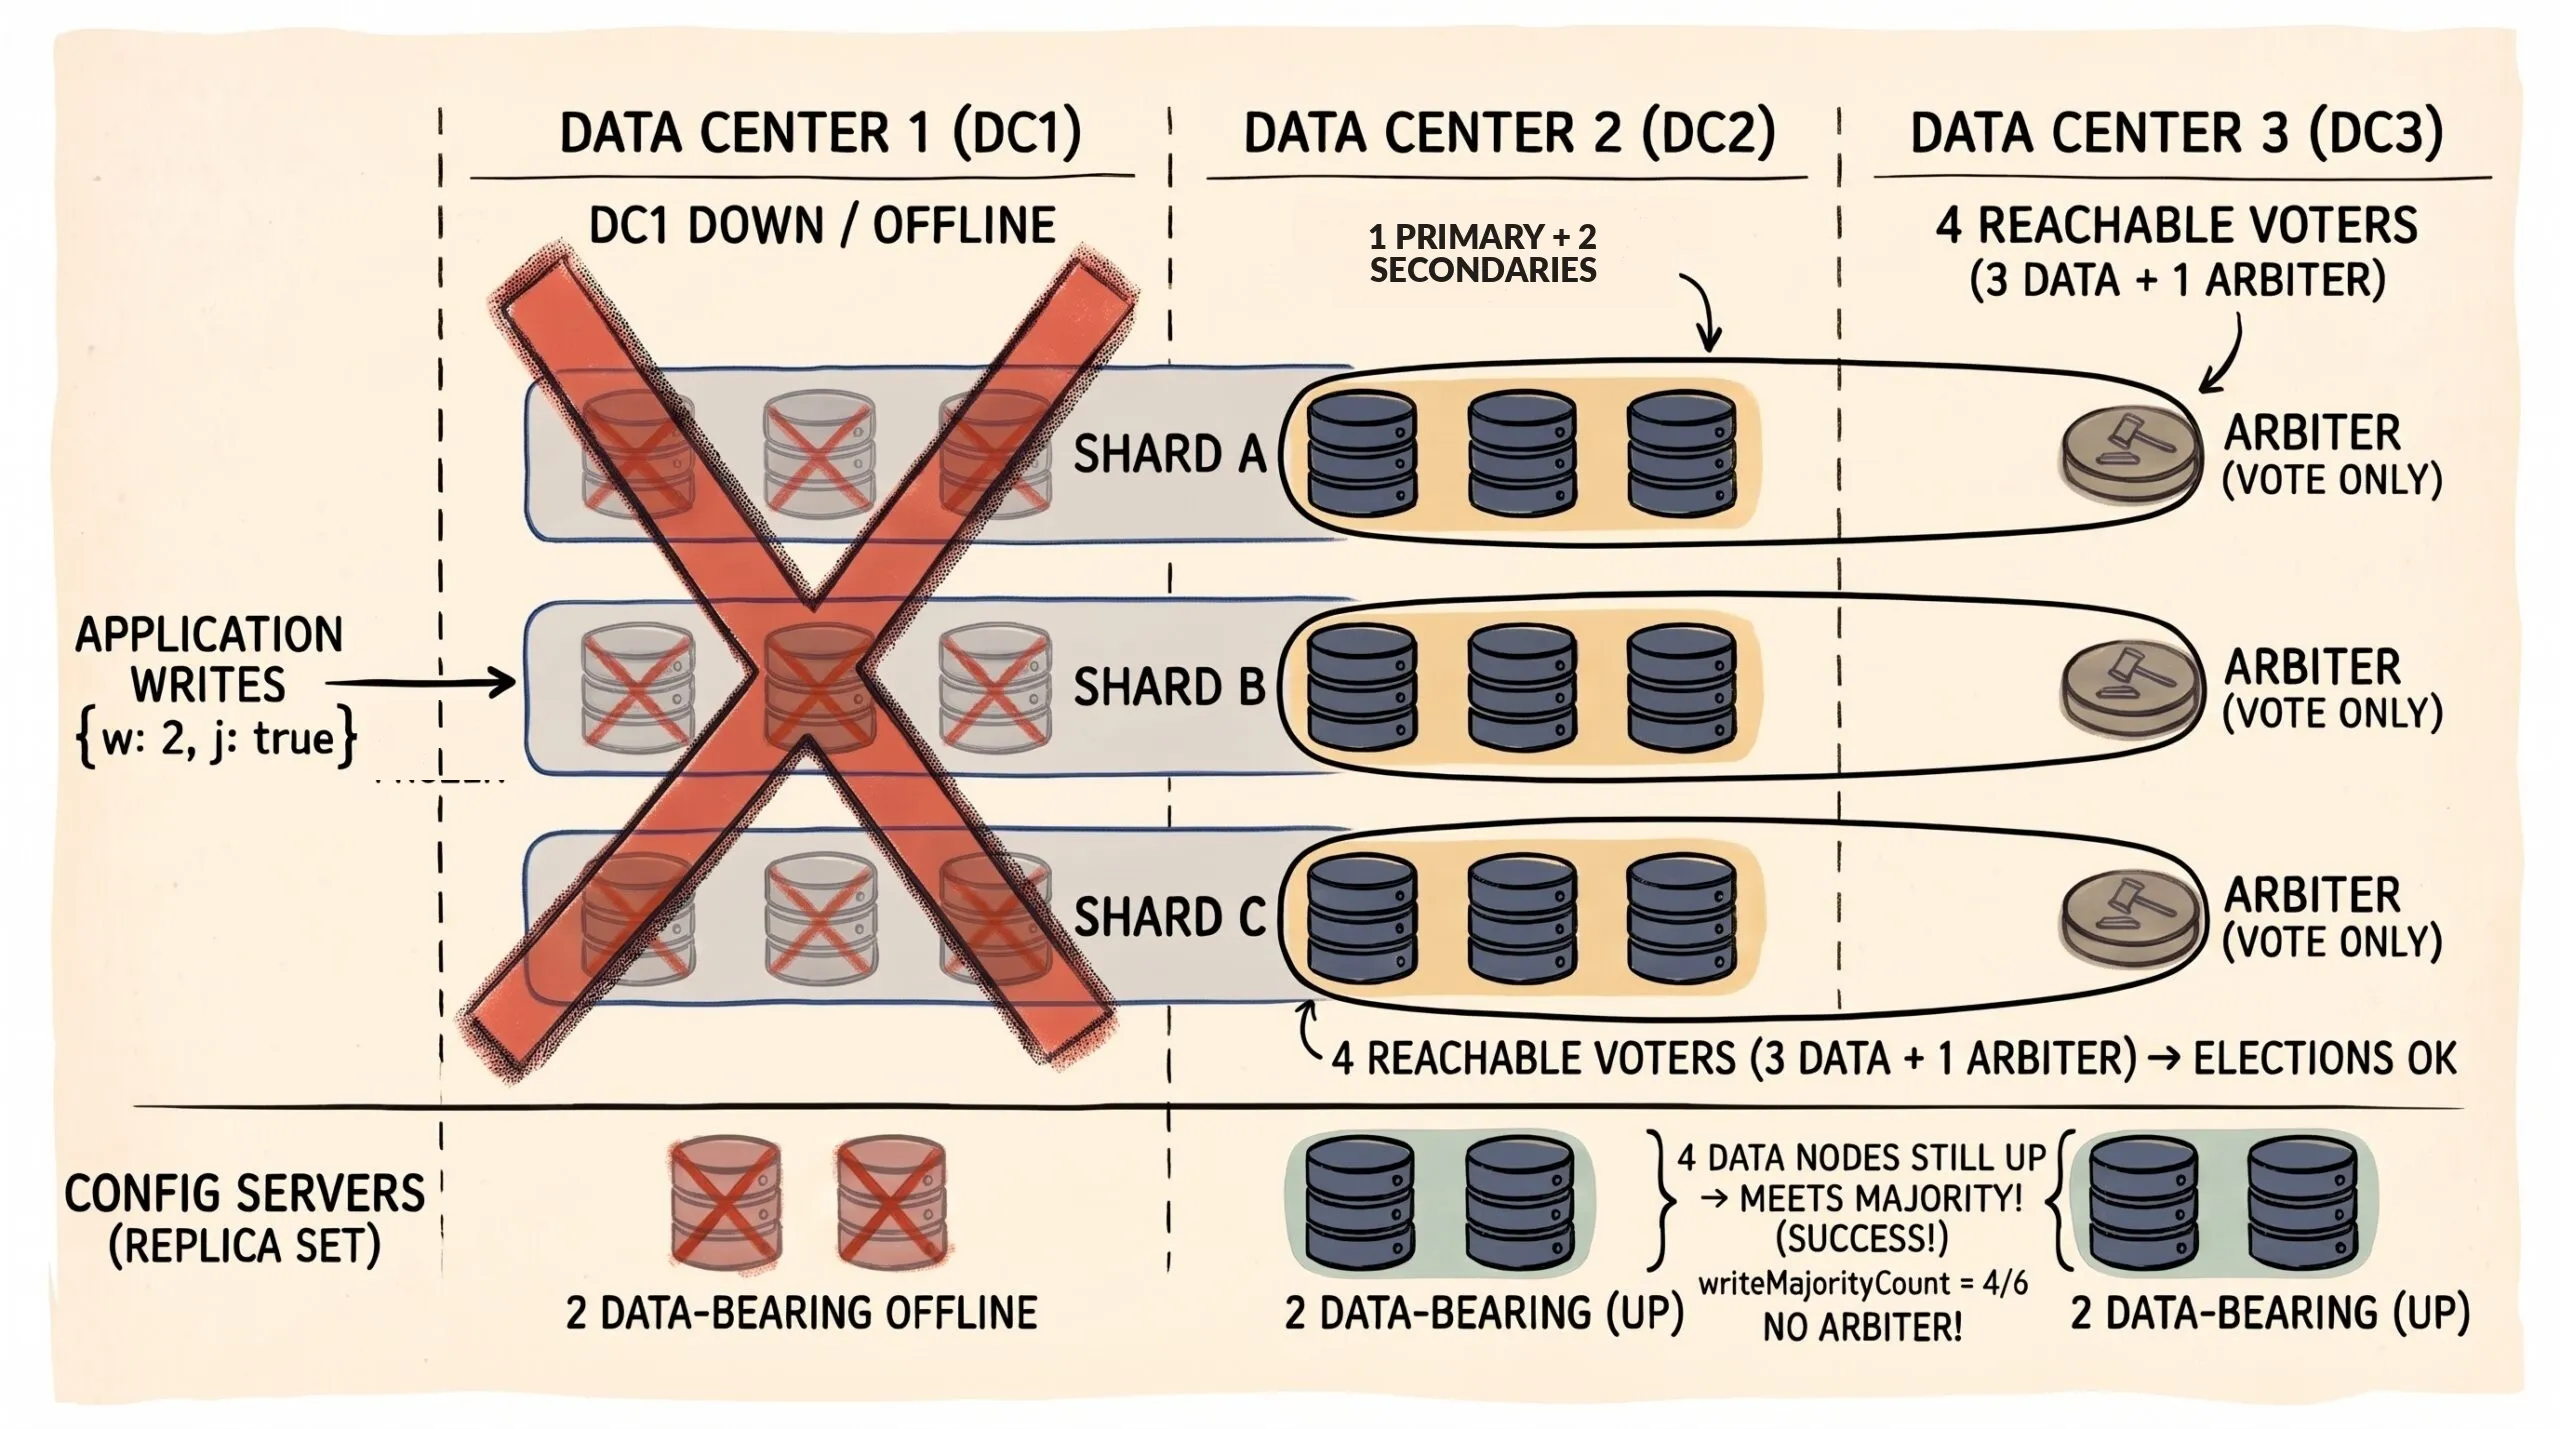
Se a aplicação usava { w: 2, j: true }, e quatro membros ainda eram alcançáveis (três com dados, mais o árbitro), por que o throughput desabou?
- Porque algumas operações internas de um sharded cluster, inclusive as que atualizam o roteamento das collections, rodam um no-op local com write concern majority. Esse no-op ignora o
{ w: 2 }da operação do cliente. - Com sete votantes e um arbiter,
writeMajorityCountera 4. O arbiter vota, mas não consegue reconhecer uma escrita de dados. - Três membros com dados disponíveis não fecham 4, então o majority commit point congelou, e o refresh ficou num timeout fixo de uns 60 segundos.
- Os config servers não enfrentou esse problema: depois da mesma perda de data center, quatro dos seis membros com dados ainda estavam de pé, o que bastava para a majority deles.
3 DCs, 6 nós com dados, 1 árbitro. No papel, uma topologia forte. Mas bastou uma falha para a disponibilidade ir ladeira abaixo, porque a majority ainda pedia quatro reconhecimentos de nós com dados, e o arbiter não era um deles.
Caso 2 – Flow control, com um arbiter que não podia ajudar:
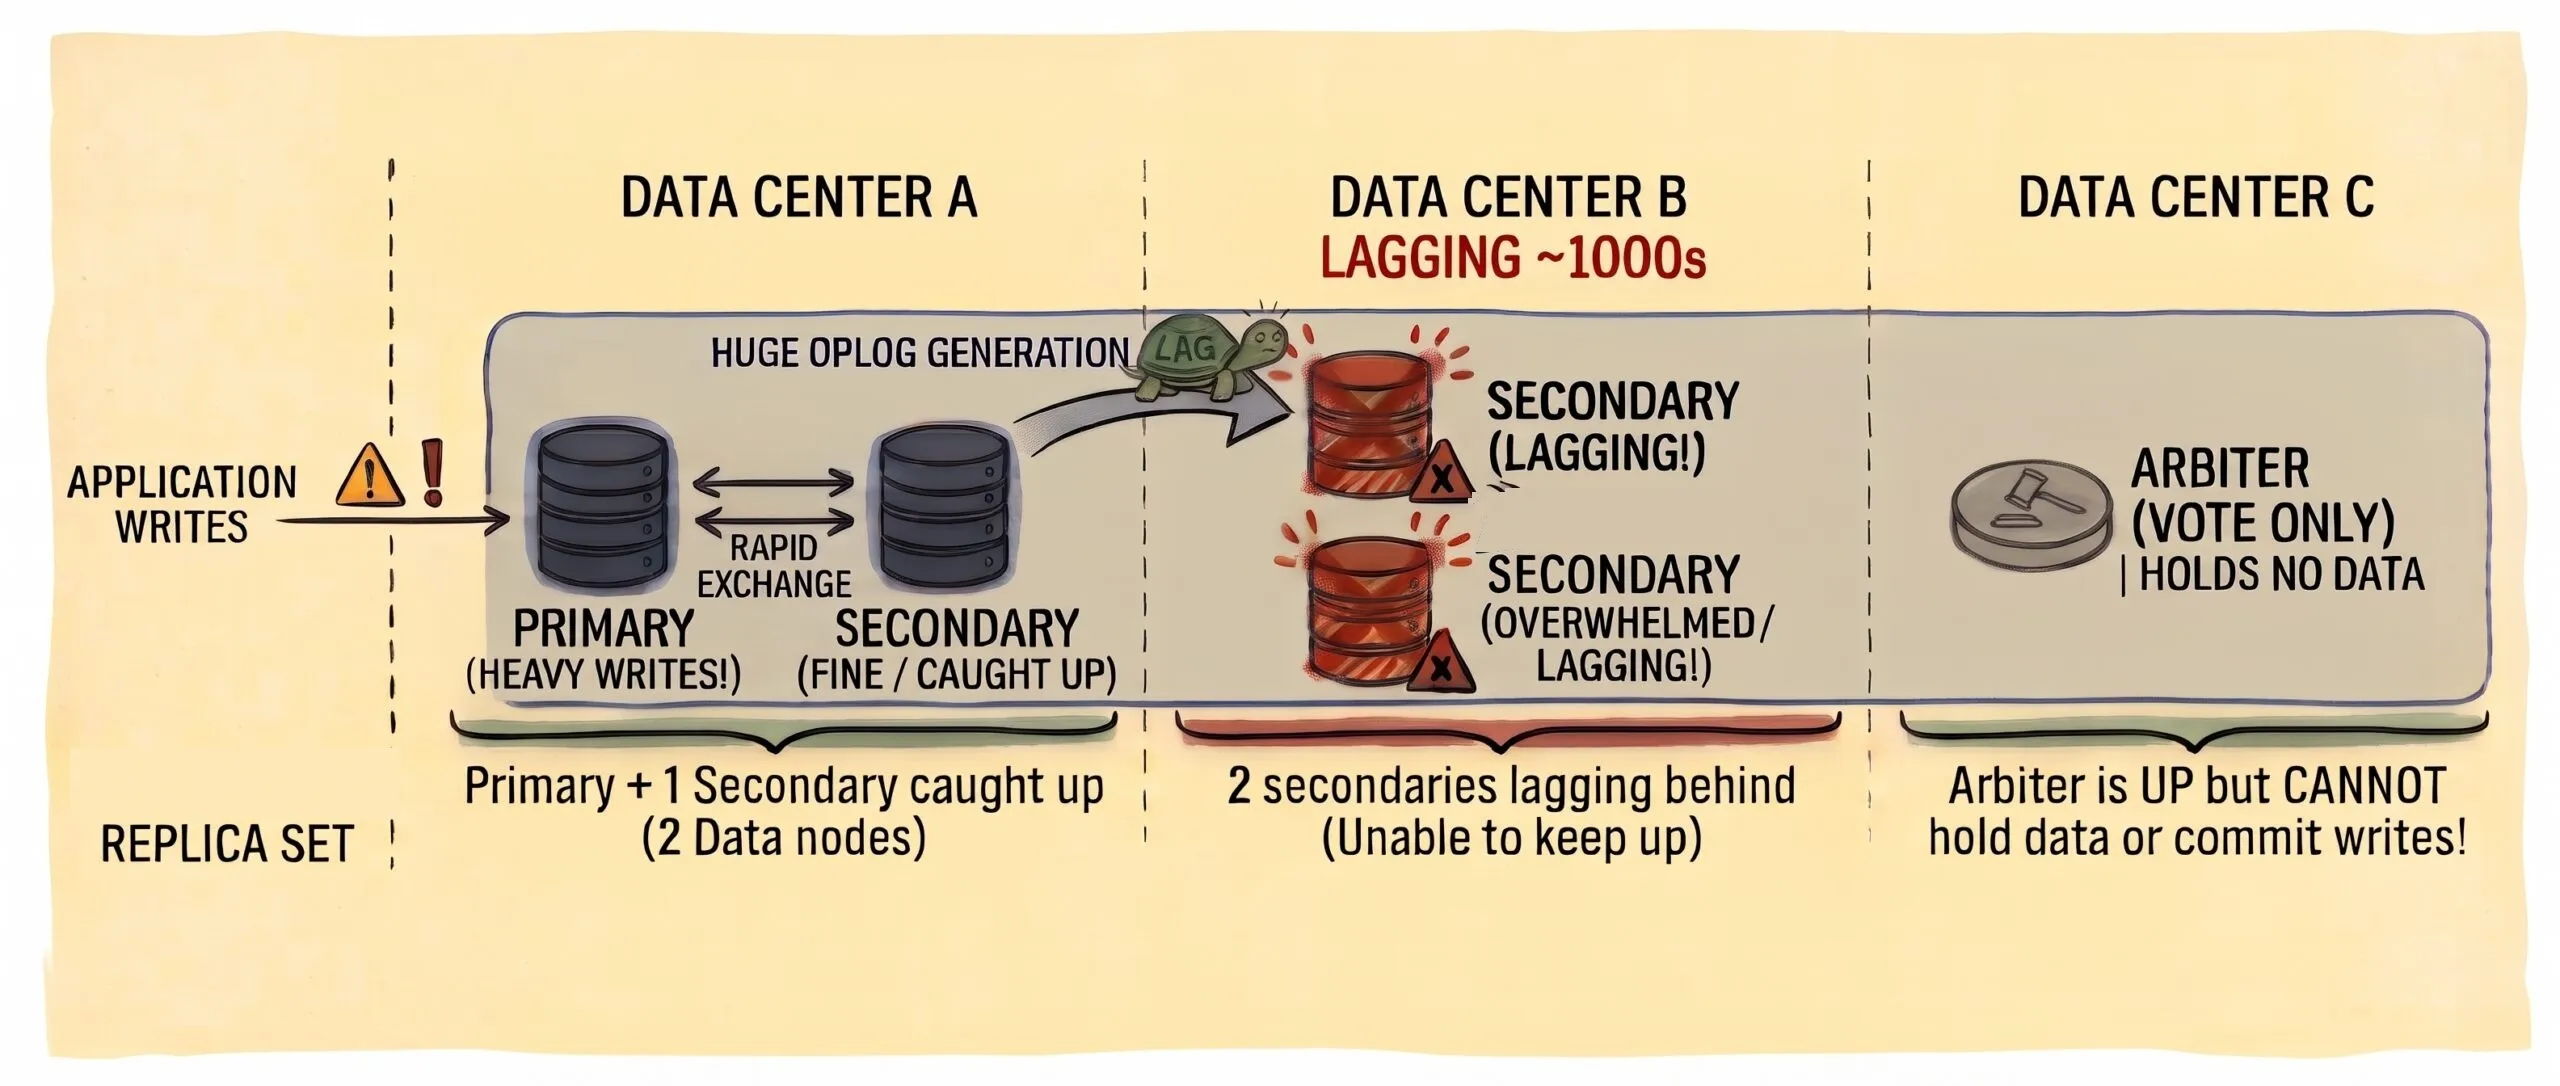
Um replica set com quatro membros com dados e um arbiter: dois nós com dados num data center, dois no outro, e o arbiter num terceiro site.
- Dois secondaries num data center estavam atrasados, no pior momento por volta de 1000 segundos. O primary e o outro secondary estavam bem.
Havia escrita pesada por causa de um projeto em andamento. A geração de oplog no primary ficou enorme, e essa carga cascateou para os secondaries.
- Secondary no mesmo DC do PRIMARY = bem
- Secondaries no DC atrasado = mal
Adivinha o que aconteceu?
Flow control. Com quatro membros com dados, o majority commit point só anda quando pelo menos três deles aplicaram a escrita.
O primary e um secondary estavam em dia. Os outros dois, não.
Dois não é três, então o commit point parou e o flow control segurou as escritas no primary. O arbiter ficou de pé o tempo todo. Ele não guarda dado, então nunca contou para esse ponto.
Caso 3 – Um PRIMARY perdido num P-S-A, e cadê os meus dados?
Um conjunto Primary-Secondary-Arbiter.
O primary tinha priority 2 na eleição. A aplicação escrevia com w: 1.
O primary caiu (N1). O secondary (N2) virou primary (é para isso que o arbiter existe).
Por cerca de uma hora, a aplicação continuou escrevendo, e essas escritas foram reconhecidas.
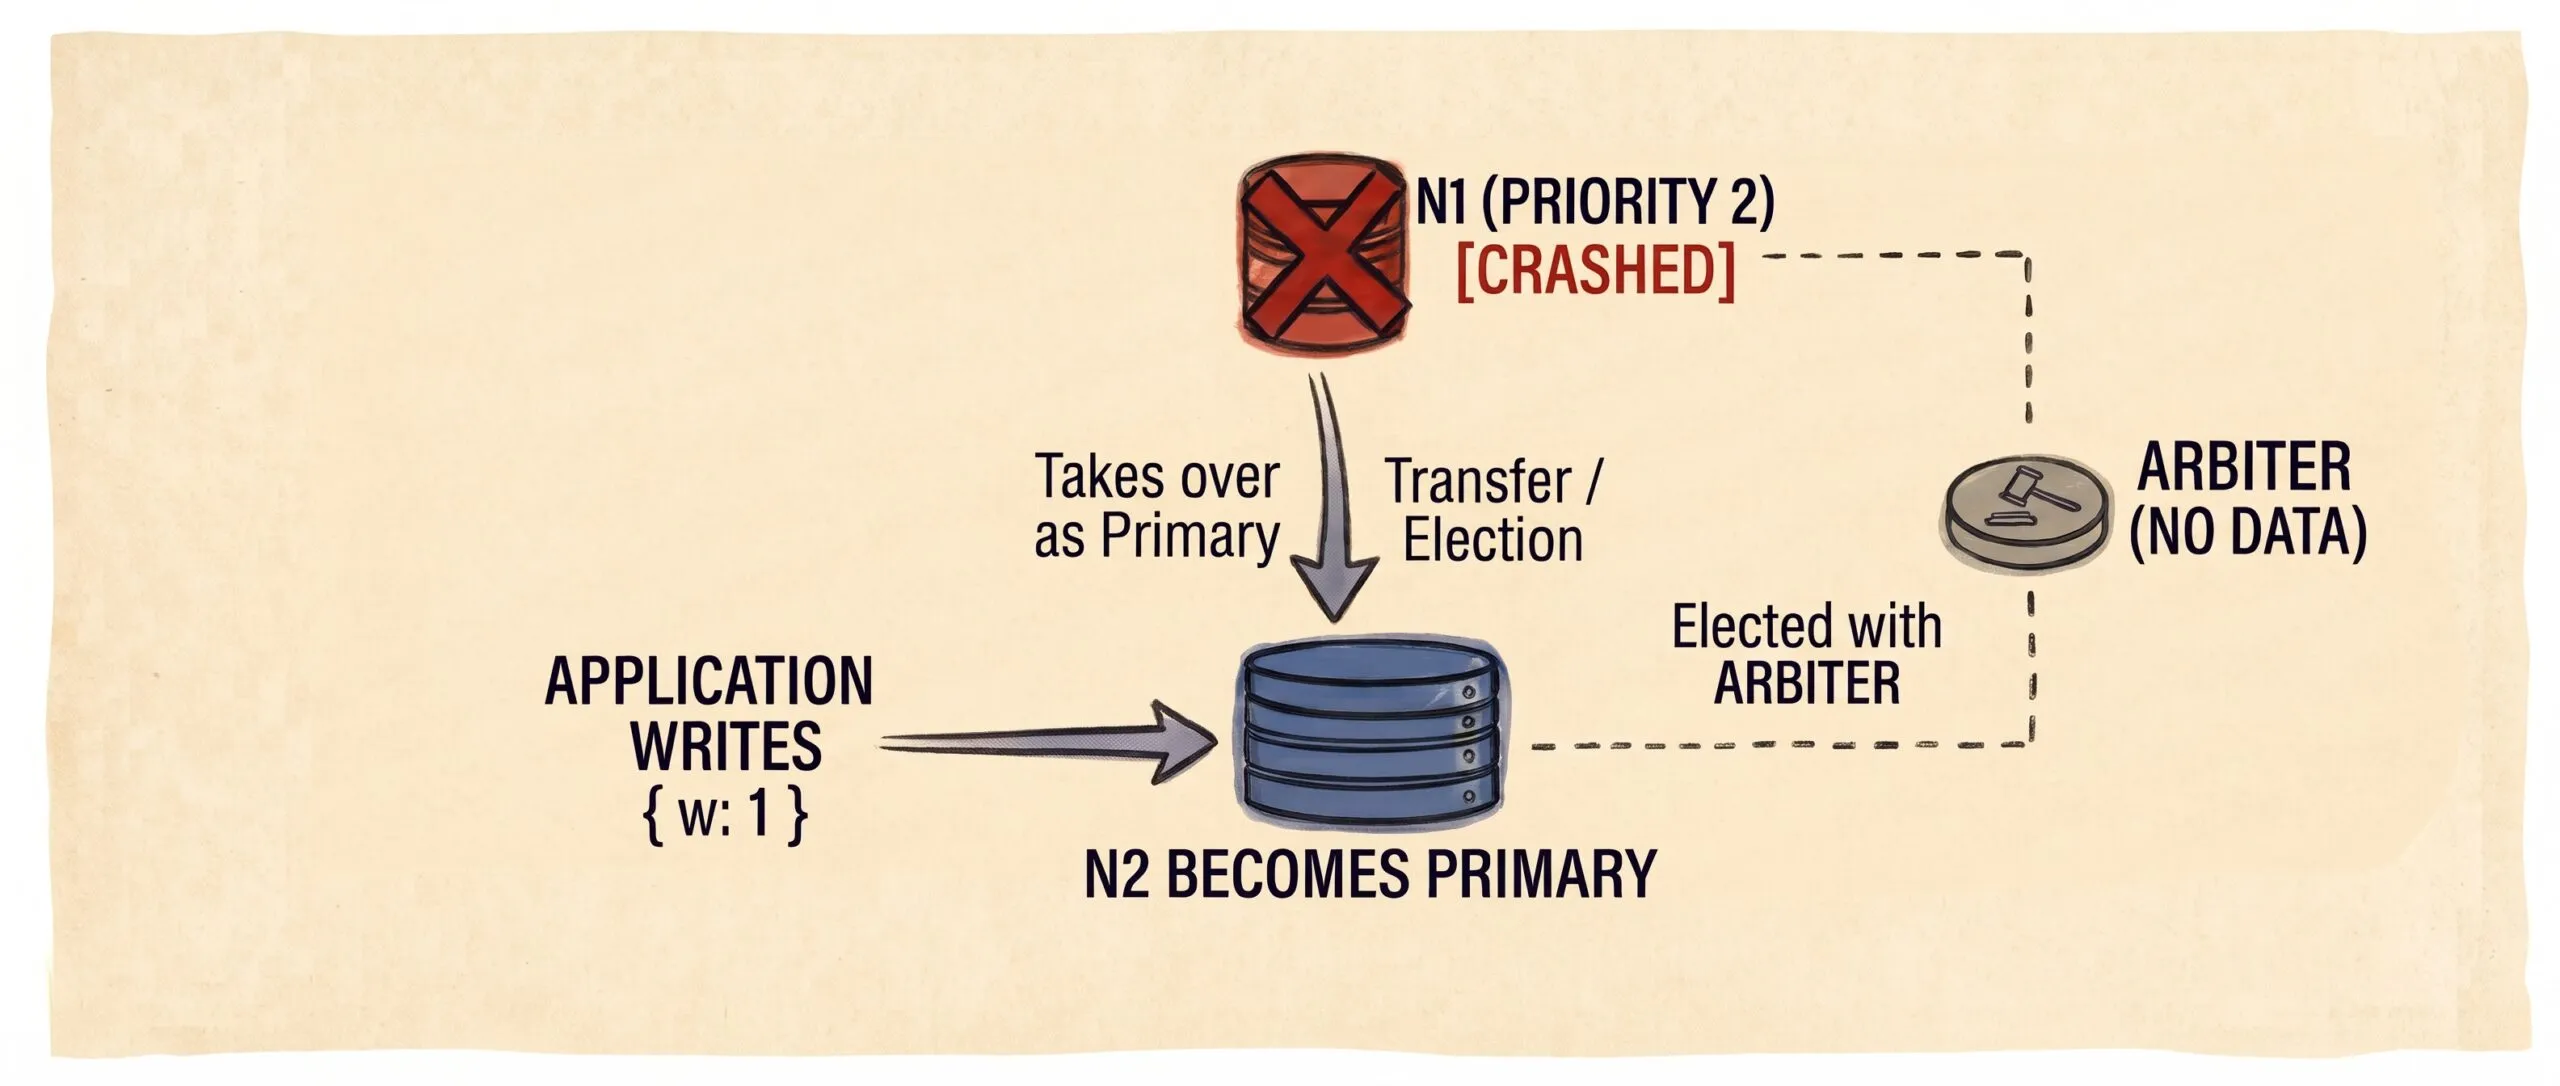
Aí o nó que tinha caído (N1) foi iniciado de novo e começou o catch-up. No meio disso, o primário temporário (N2) caiu. O N1 ainda não tinha alcançado.
Ele (N1) e o árbitro eram maioria, então ele ganhou a eleição. Virou primary com os dados que tinha naquele momento, que não estavam em dia.
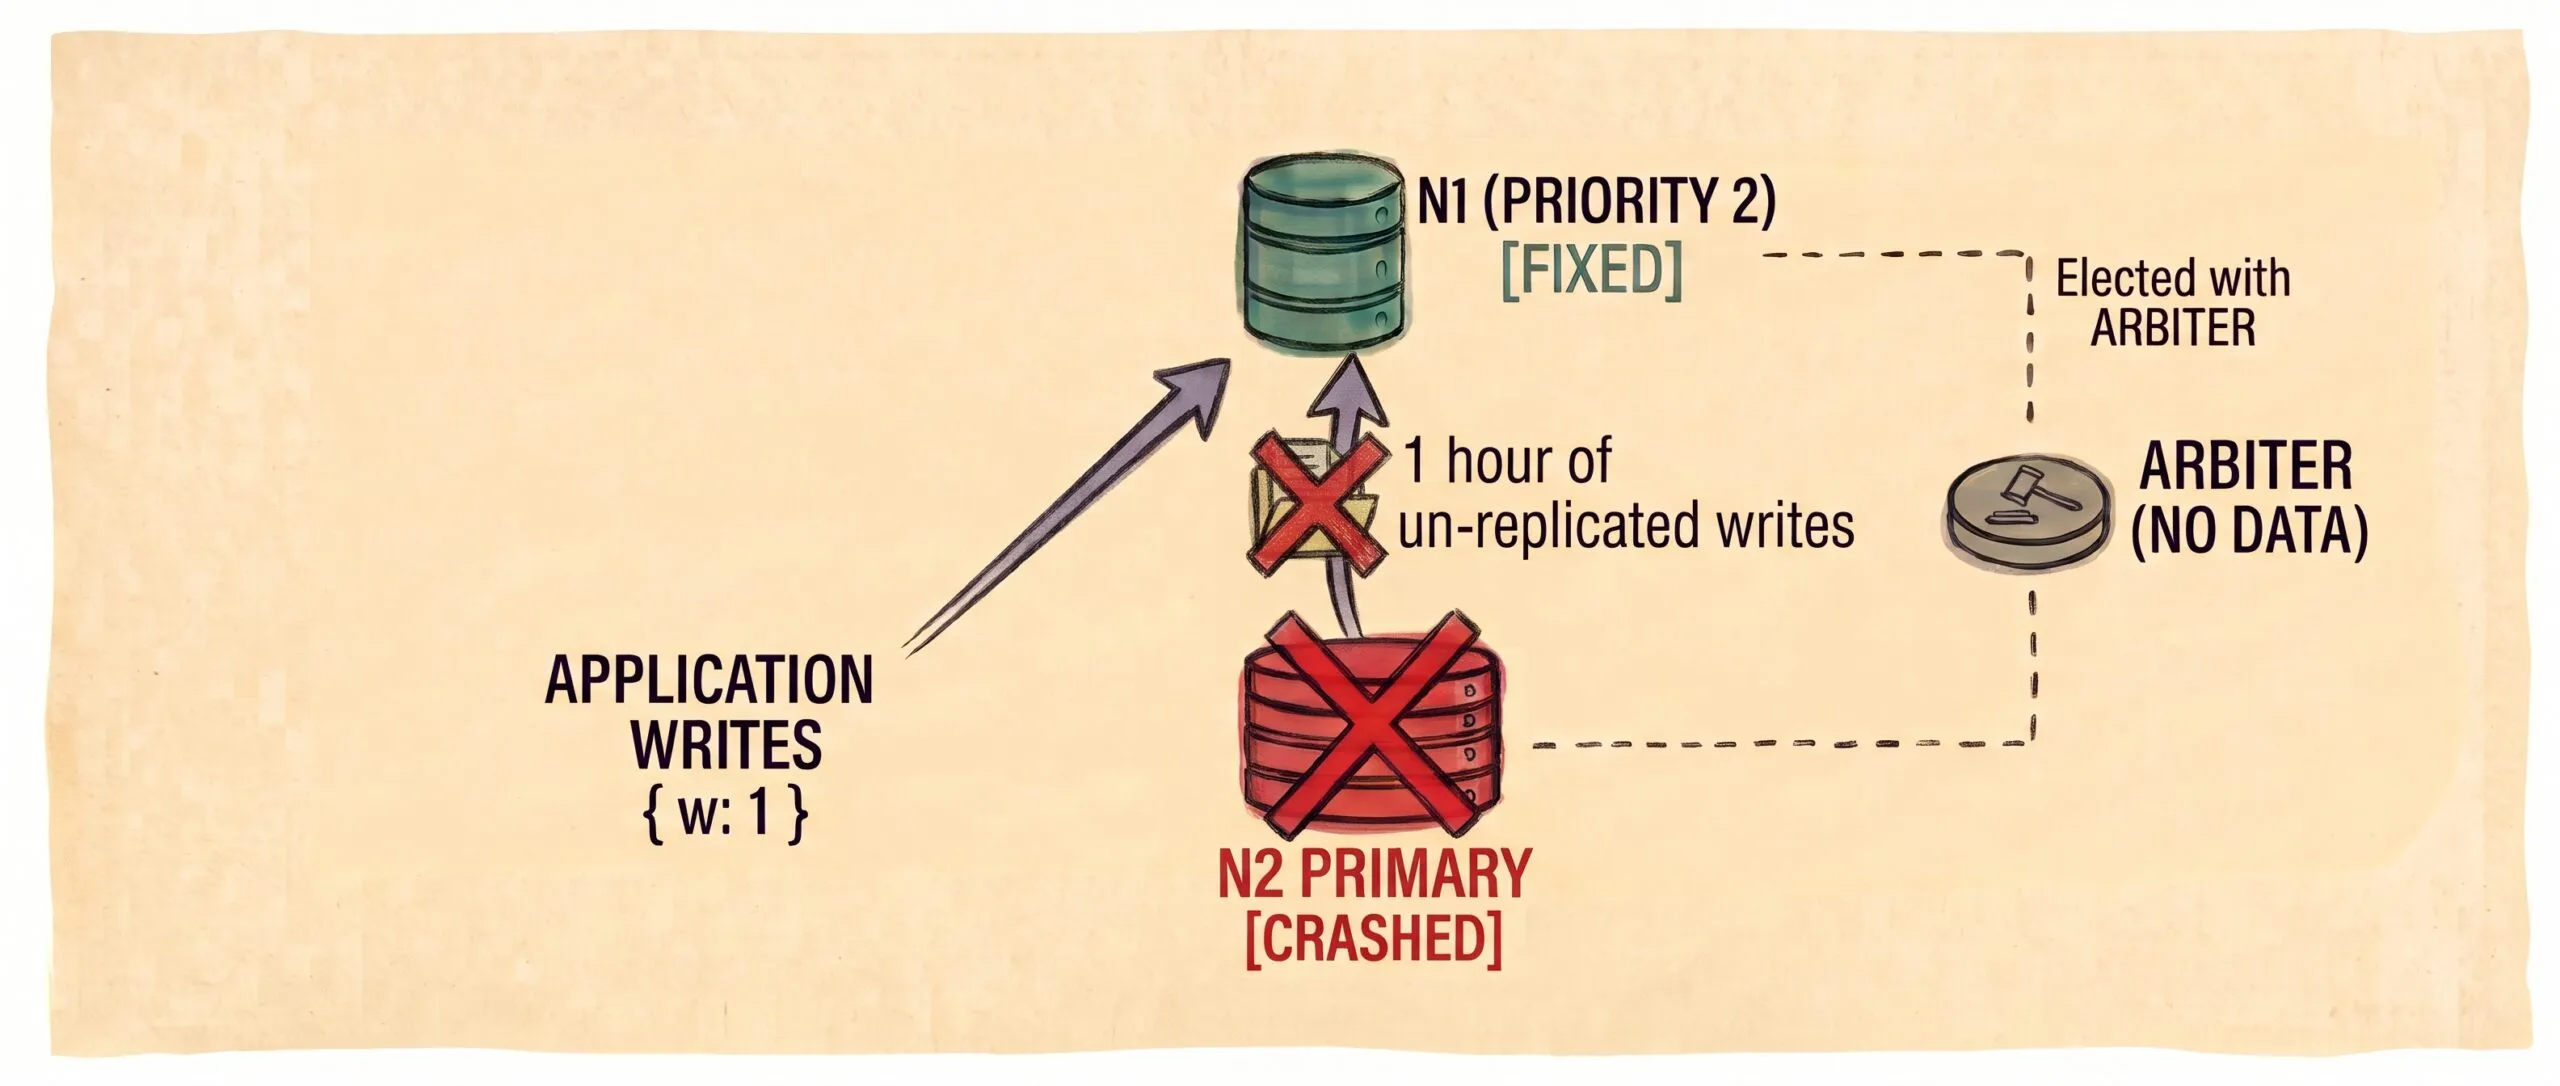
Os documentos daquela hora de trabalho com N2 tinham sumido.
“Dois é um, e um é nenhum.” Essas escritas só existiam no primary temporário (N2). O arbiter não guarda dado, e o N1 estava fora enquanto elas aconteciam, então ninguém mais tinha uma cópia delas.
Quando o N2 voltou, estava à frente do ponto em comum no oplog. Ele (N2) fez rollback para casar com o primary (N1), que nunca tinha visto aqueles documentos.
Os documentos revertidos ainda estavam em disco, como bson, no diretório rollback dentro do dbPath. Foi assim que foram recuperados. O replica set não tinha replicado esses documentos.
Com um terceiro nó que guarda dados, no lugar do arbiter, o caso poderia ter sido outro. Mesmo com w: 1, um terceiro nó que estivesse de pé e replicando, muito provavelmente já teria aqueles dados. Estaria na frente do N1, então viraria primary. O N1 alcançaria a partir dele, e só então tomaria o primary de volta por priority.
A lista poderia continuar, mas acredito que o ponto aqui já está claro. Parte do trabalho, numa análise de causa raiz ou numa ligação de emergência, é desemaranhar esses mal-entendidos e explicar o por que o árbitro teve papel zero e maior parte dos casos.
O árbitro estava na maioria dos votos. Nunca esteve na maioria em que escrita, commit e flow control de fato esperam.
O que a documentação já te diz.
Digamos que mesmo após esses casos, você não se sente convencido de parar de usar árbitros de produção, então value a pena dar uma olhada no manual, que vem empilhando os mesmos avisos a algum tempo.
Conjuntos de três membros: P-S-S está marcado como recomendado. PSA é a redução de custo, com redundância e tolerância a falha mais fracas, já que você só tem duas cópias completas dos dados.
Não rode um árbitro num host que já roda um primary ou um secondary. Se esse host morre, você perde o dado e o voto juntos. Mais de um árbitro enfraquece o write concern majority.
Se o secondary está indisponível ou atrasado, o write concern "majority" pode causar problema de performance, como nos casos acima. Num P-S-A, basta um secondary cair ou ter problema.
A partir do MongoDB 5.3, o suporte a vários arbiters num replica set vem desligado por padrão.
Isso acontece pelos problemas que descrevemos. Vários árbitros impedem o uso confiável do write concern majority. Vários árbitros permitem que o replica set aceite escritas mesmo quando não há secondaries suficientes para replicar os dados.
Você não pode mudar uma shard key usando uma transação se o replica set tem um árbitro.
Árbitros não participam das operações de dados exigidas por transações multi-shard.
Transações cujas escritas atravessam vários shards dão erro e abortam se qualquer operação da transação lê ou escreve num shard que contém um árbitro.
Por último, vale mencionar que o uso de árbitro não é suportado em nenhum tier do MongoDB Atlas.
Com milhares de clusters no ar, usar Árbitros seria um jeito fácil de reduzir o custo de nós com dados. Mas quando a gente pesa os dois lados, essa economia viria com um preço: o risco de o produto falhar na frente dos usuários.
Conclusão
O uso de Árbitros foi um jeito barato de conseguir um número ímpar de votos. Ainda é.
Nunca foi um jeito de conseguir durabilidade, e o produto passou a última década fazendo da durabilidade a coisa em que o cluster de fato espera.
Quando você analisa os riscos e as armadilhas em que dá para cair, o assunto de redução de custo muda de lado.
- Quanto você perde num cluster travado? Escritas estourando timeout, uma ligação emergencial, e usuários olhando para um produto que está de pé no
rs.status()e caído para eles.
Até você entender o que houve, pode ser tarde, e o nó com dados que você resolveu não implementar era a linha mais barata da conta.
Se você já é um DBA de MongoDB calejado e conhece essas observações, um árbitro em produção pode não ser um dos seus maiores problemas agora.
Para todo o resto, se você quer uma fraqueza a menos que possa virar incidente, evite árbitros em produção. Eles causam falhas que não parecem problema de eleição, e essas são as que mais demoram para serem percebidas.